
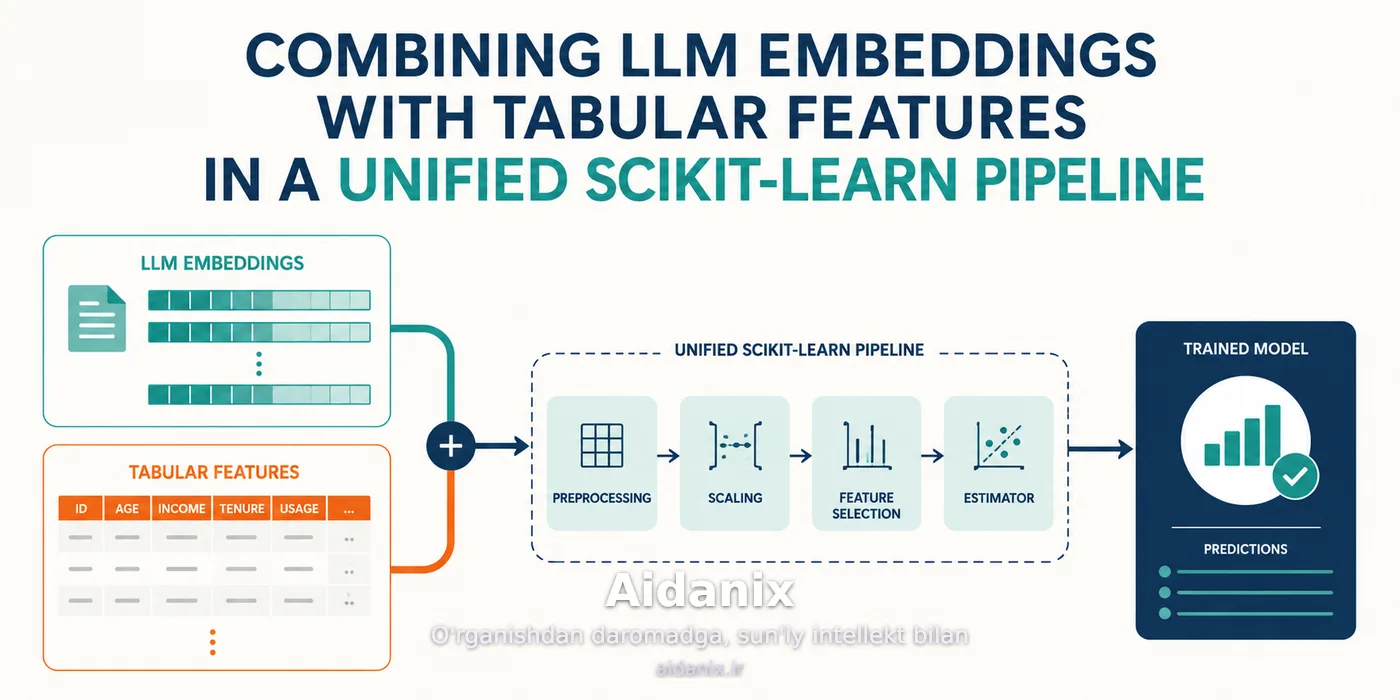
Ushbu maqola scikit-learn kutubxonasidan foydalanib, yengil ochiq manbaali til modeli tomonidan yaratilgan matnli chiqishlarni tuzilgan (jadval) xususiyatlar bilan hamkorlikda qayta ishlovchi integrallashtirilgan tayyorlash tizimini qurishning amaliy usulini taklif etadi. Ushbu yondashuv yirik til modellarining (LLM) imkoniyatlarini an’anaviy mashinani o’qitish jarayonlari doirasida, odatdagi «bir marta generatsiya, hech qachon qayta ishlash» uslubiga tayanmasdan ishlatish imkonini beradi.
Ushbu arxitekturaning asosiy maqsadi kamarbali API’larning cheklovlari, ya’ni past tezlik yoki yuqori xarajatlar muammoiga g’alaba qozonishдан iborat. Bu ikki ma’lumot manbasini bitta yagona tizimga integratsiya qilish orqali yakuniy model o’z ichida chuqur til konteksti va aniq sonli tuzilmalardan bir vaqtda foydalanishi mumkin bo‘lib, bu murakkabrog‘i vazifalarda prognozning aniqquligini yuksaltirish imkonini beradi. Ushbu usul og‘ir GPU infratuzilmasini talab qilmasda, tez va takrorlano beradi eksperimentlarni olib borishni xohlovchi tadbirkorlar uchun kuchli vosita bo‘lib xizmat qiladi.