
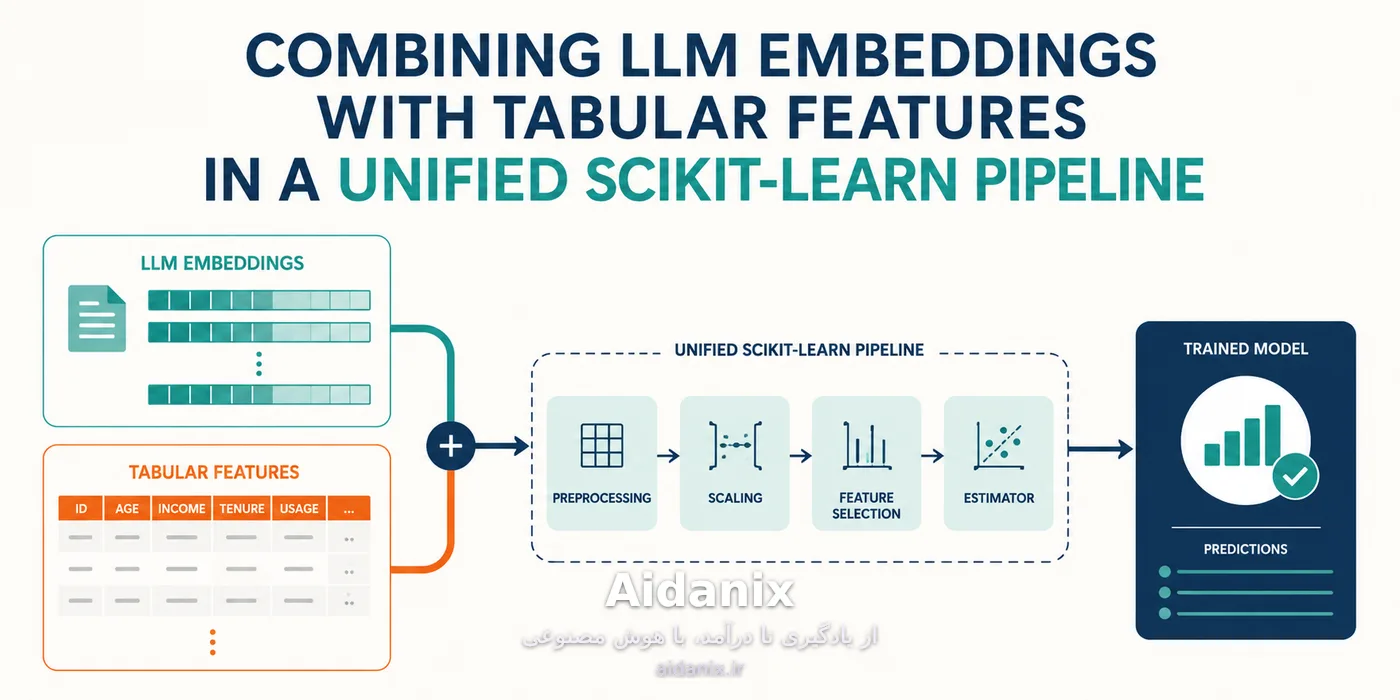
در این مقاله، یک روش عملی برای ساختن یک پایپلین یکپارچه در کتابخانه اسکیتلرن (scikit-learn) ارائه میشود که در آن امدههای متنی تولیدشده توسط یک مدل زبانی سبکوزن و متنباز، بهصورت هماهنگ با ویژگیهای ساختاریافته (جدولی) پردازش میشوند. این رویکرد امکان استفاده از قدرت مدلهای زبانی بزرگ (LLM) را در فرآیندهای یادگیری ماشین سنتی فراهم میکند، بدون اینکه به الگوی رایج «یکبار تولید شود و هرگز دوباره استفاده نشود» وابسته بود.
هدف اصلی از این معماری، عبور از محدودیتهای APIهای سبک میباشد که معمولاً سرعت پایین یا هزینه بالا دارند. با ادغام این دو منبع دادهای در یک چارچوب واحد، مدل نهایی میتواند همزمان از بافتهای زبانی عمیق و ساختارهای عددی دقیق بهرهبگیرد، که میتواند دقت پیشبینی در مسائل پیچیدهتر را بهبود بخشد. این روش برای پژوهشگرانی که میخواهند آزمایشهای سریع و قابل تکرار بدون نیاز به زیرساختهای سنگین GPU انجام دهند، ابزاری قدرتمند است.