
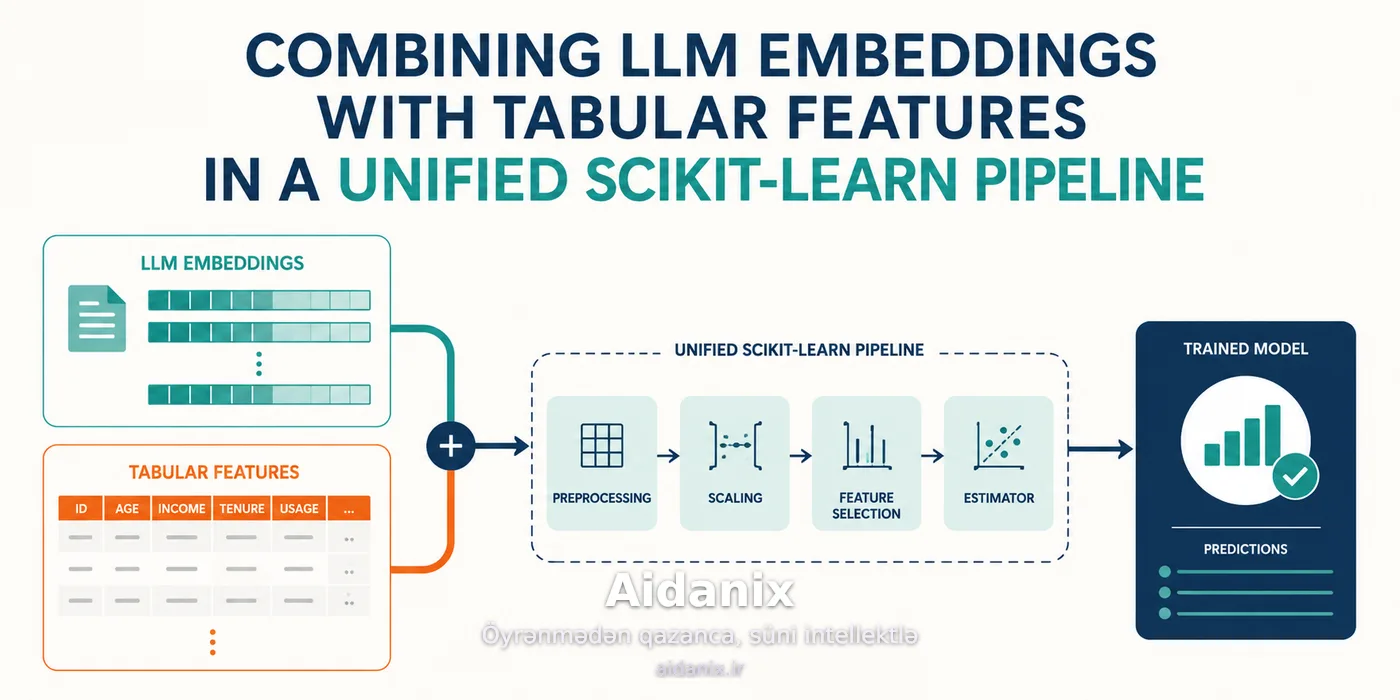
این مقاله روش عملیاتی برای ساخت یک خط لوله یکپارچه با استفاده از کتابخانه scikit-learn ارائه میدهد که در آن خروجیهای متنی تولیدشده توسط یک مدل زبانی سبکوزن و متنباز، همزمان با ویژگیهای ساختاریافته (جدولی) پردازش میشوند. این رویکرد امکان بهرهگیری از ظرفیتهای مدلهای زبانی بزرگ (LLMها) در چرخههای کاری传统 یادگیری ماشین را فراهم میکند، بدون اینکه به الگوی رایج «یکبار تولید شود، هرگز استفاده نشود» وابسته باشد.
هدف اصلی این معماری از بین بردن محدودیتهای APIهای سبکوزن است که معمولاً با سرعت پایین یا هزینههای بالا دستوپنجه نرم میکنند. با یکپارچهسازی این دو منبع داده در یک چارچوب واحد، مدل نهایی میتواند همزمان از زمینه زبانی عمیق و ساختارهای عددی دقیق بهرهمند شود که این امر میتواند دقت پیشبینی را در وظایف پیچیدهتر بهبود بخشد. این روش ابزاری قدرتمند برای محققانی است که به دنبال آزمایشهای سریع و قابل تکرار هستند، بدون نیاز به زیرساختهای سنگین GPU.