
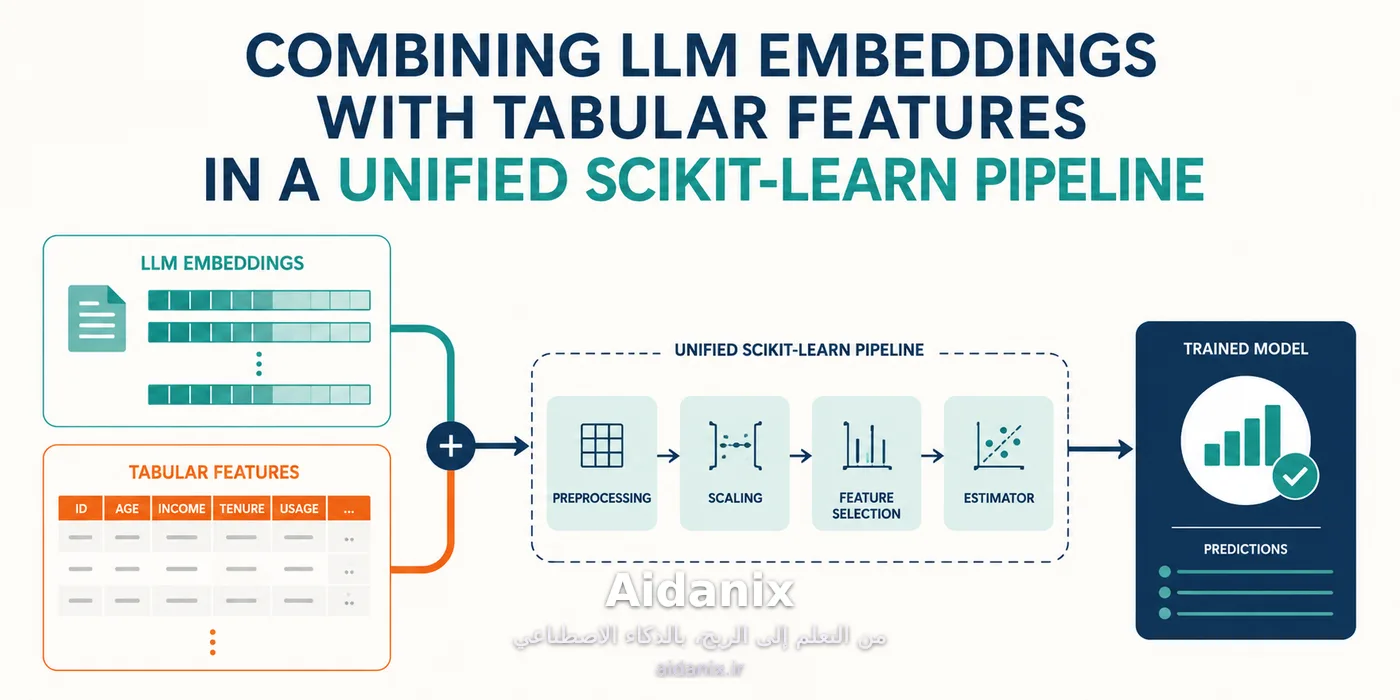
تشریح میکند که چگونه یک خط لوله یکپارچه با استفاده از کتابخانهی scikit-learn ساخته میشود، که در آن خروجیهای متنی حاصل از یک مدل زبانی سبک و متنباز بهطور هماهنگ با ویژگیهای ساختاریافته (جدولی) پردازش میشوند. این رویکرد امکان بهرهگیری از قابلیتهای مدلهای زبانی بزرگ (LLMs) را در چرخههای سنتی یادگیری ماشین فراهم میآورد، بدون اینکه به الگوی رایج «تولید یکبار، استفاده هرگز» وابسته باشد.
هدف اصلی این معماری، غلبه بر محدودیتهای APIهای سبک است که معمولاً با سرعت پایین یا هزینههای بالا دستوپنجه نرم میکنند. از طریق یکپارچهسازی این دو منبع داده در یک چارچوب منسجم، مدل نهایی میتواند همزمان از بافت زبانی عمیق و ساختارهای عددی دقیق بهرهمند شود و بهاحتمال زیاد دقت پیشبینی را در کارهای پیچیدهتر بهبود بخشد. این روش ابزاری قدرتمند برای پژوهشگرانی فراهم میکند که بهدنبال آزمایشهای سریع و قابل تکرار هستند، بدون نیاز به زیرساختهای سنگین GPU.